
Series: Crescent Island soll mit 480 GB Speicher und 1,3 PFLOPS punkten
Werbung
Mit der GPU D-Series gibt Intel seinem bereits im Oktober 2025 angekündigten KI-Beschleuniger mit dem Codenamen Crescent Island einen offiziellen Produktnamen. Nachdem auf der Computex 2026 und zuletzt auf der Hot-Chips-Konferenz weitere technische Details veröffentlicht wurden, konkretisiert Intel zum Open Compute Project Global Summit nun die Leistungsdaten und die Positionierung der neuen Hardware.
Anders als die auf möglichst hohe Rechenleistung ausgelegten KI-Beschleuniger von NVIDIA und AMD konzentriert sich Intel mit der GPU D-Series vor allem auf eine hohe Speicherkapazität, eine möglichst effiziente Ausführung von Inferenz-Workloads und den Einsatz in bestehenden Rechenzentrumsinfrastrukturen. Besonders bei großen Sprachmodellen, langen Kontextfenstern und der parallelen Ausführung zahlreicher KI-Agenten sieht das Unternehmen einen wachsenden Bedarf an entsprechend spezialisierter Hardware.
Technische Grundlage der GPU D-Series ist die Xe3P-Architektur, deren Aufbau Intel bereits auf der Hot-Chips-Konferenz näher erläuterte. Der Chip verfügt über insgesamt 32 Xe-Cores, die in vier Compute Slices mit jeweils acht Xe-Cores organisiert sind. Neben den klassischen Vektor-Recheneinheiten (XVE) stehen insgesamt 256 XMX-Matrix-Engines für die Beschleunigung von KI-Berechnungen zur Verfügung. Hinzu kommen ein 32 MB großer Unified-L2-Cache sowie eine Media Engine mit jeweils vier Encoder- und Decoder-Einheiten, die beispielsweise bei der Verarbeitung multimodaler KI-Anwendungen zum Einsatz kommen können. Die Xe3P-Architektur bietet zudem Verbesserungen bei der parallelen Abarbeitung unterschiedlicher Aufgaben, unter anderem durch Same Address Multi-Queue und Hardware-Unterstützung für Aktivierungsfunktionen wie Sigmoid und Tanh. Für Berechnungen im FP8-Datenformat nennt Intel nun eine maximale Rechenleistung von 1,3 PFLOPS. Die Architektur unterstützt darüber hinaus weitere Datentypen bis hinunter zu FP4 sowie FP64 für Anwendungen, die eine höhere Rechengenauigkeit benötigen.
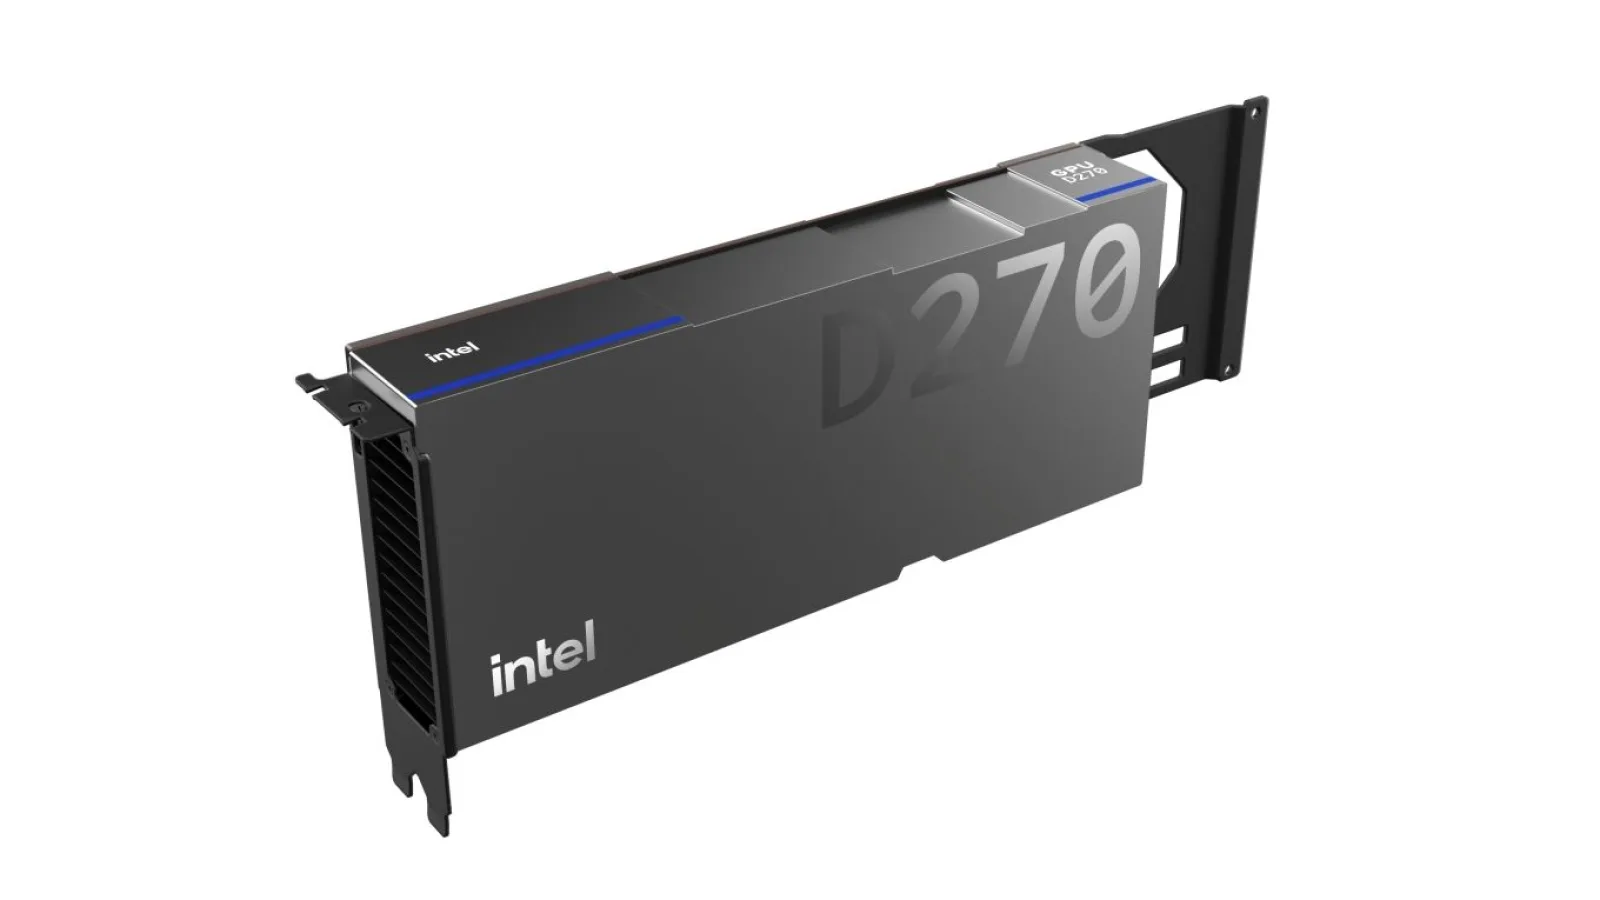
Zum OCP Summit 2026 liefert Intel ein erstes Rendering des PCIe-Beschleunigers:
Ein besonderes Merkmal der GPU D-Series ist die Speicherausstattung. Intel verzichtet auf den bei vielen aktuellen KI-Beschleunigern eingesetzten HBM und verwendet stattdessen LPDDR5X. Die bereits im vergangenen Jahr angekündigte Referenzkarte von Intel wird mit 160 GB ausgestattet. Das Design ermöglicht es den Partnern allerdings, eigene Beschleuniger mit bis zu 480 GB LPDDR5X anzubieten. Damit wird auch klar, wie die bereits zur Computex kommunizierte maximale Speicherkapazität erreicht werden soll.
Die Speicheranbindung erfolgt über ein 1.280 Bit breites Interface. Mit LPDDR5X-9600 ergibt sich eine theoretische Speicherbandbreite von 1,536 TB/s, während Intel offiziell rund 1,5 TB/s nennt. Damit bleibt die Bandbreite zwar deutlich unter der aktueller HBM-basierter High-End-Beschleuniger, die Speicherkapazität kann für bestimmte Inferenz-Anwendungen jedoch wichtiger sein. Gerade bei langen Kontextfenstern und vielen gleichzeitigen Anfragen benötigt der sogenannte KV-Cache große Mengen an Speicher, um bereits berechnete Zwischenergebnisse vorzuhalten.
Nach Angaben von Intel sollen sich auf einer einzelnen GPU D-Series KI-Modelle mit bis zu 300 Milliarden Parametern ausführen lassen. In einem System mit acht Beschleunigern sollen sogar Modelle mit mehr als einer Billion Parametern möglich sein. Welche Quantisierung und welche weiteren Einschränkungen diesen Angaben zugrunde liegen, führt Intel allerdings nicht näher aus. Gerade bei der Ausführung großer Modelle ist die verfügbare Speicherkapazität ein entscheidender Faktor, da neben den eigentlichen Modellgewichten auch Aktivierungen und der KV-Cache berücksichtigt werden müssen. Durch den Einsatz von LPDDR5X verspricht sich Intel zudem Vorteile bei den Kosten und der Energieeffizienz. Die GPU D-Series ist als luftgekühlte PCIe-Steckkarte mit einer Leistungsaufnahme von 350 W ausgelegt. Die Anbindung erfolgt über PCIe 5.0 mit 16 Lanes. Mehrere Beschleuniger lassen sich über eine entsprechende PCIe-Switch-Infrastruktur zusammenschalten, ohne dass dafür eine speziell entwickelte Rack-Infrastruktur mit Flüssigkeitskühlung notwendig wäre.
Mit der GPU D-Series verfolgt Intel somit einen anderen Ansatz als bei früheren Versuchen, im Markt für KI-Beschleuniger Fuß zu fassen. Nachdem Gaudi 3 die Erwartungen nicht erfüllen konnte und Falcon Shores letztlich nicht als reguläres Produkt auf den Markt kam, soll Crescent Island vor allem ein wirtschaftlich attraktiver Beschleuniger für die zunehmend wichtigere Inferenz werden. Die Kombination aus hoher Speicherkapazität, vergleichsweise moderater Leistungsaufnahme und einer standardisierten PCIe-Anbindung könnte insbesondere für Unternehmen interessant sein, die große Sprachmodelle lokal betreiben oder zahlreiche gleichzeitige KI-Anfragen verarbeiten möchten. Allerdings hängt die tatsächliche Leistungsfähigkeit nicht allein von der verfügbaren Rechenleistung und Speicherkapazität ab. Entscheidend werden auch die Software-Unterstützung, die Effizienz bei der Token-Generierung, die Latenzen und letztlich die Kosten pro verarbeitetem Token sein. Intel setzt dabei auf eine gemeinsame Xe-Softwarebasis, offene Frameworks und die Integration bestehender Inferenz-Runtimes. Nach Unternehmensangaben läuft die Bemusterung bei ersten Kunden bereits.
Ob Intel mit der GPU D-Series tatsächlich eine konkurrenzfähige Alternative zu den etablierten Angeboten von NVIDIA und AMD liefern kann, bleibt abzuwarten. Die bisher veröffentlichten technischen Daten zeigen zwar eine klare Ausrichtung auf speicherintensive Inferenz-Workloads, unabhängige Benchmarks zur tatsächlichen Leistung und Energieeffizienz fehlen jedoch weiterhin. Ebenso stehen konkrete Angaben zu Preisen und einer breiten Verfügbarkeit noch aus. Gerade das Verhältnis aus Anschaffungskosten, Speichergröße und Inferenz-Durchsatz dürfte darüber entscheiden, ob Intel mit der GPU D-Series nach mehreren wenig erfolgreichen Anläufen wieder einen relevanten Anteil am wachsenden Markt für KI-Beschleuniger erreichen kann.